プログラミング学習や組込み開発の現場で、「コードは合っているはずなのに未定義シンボル(undefined reference)エラーが出る」「if文の文字列一致判定がなぜか意図通りに動かない」といったトラブルに直面するケースは後を絶ちません。その根本的な原因の多くは、C言語における大文字・小文字の厳格な区別(Case-sensitive)という基本仕様にあります。
初学者から中堅エンジニアに至るまで、OSの違いや標準ライブラリの差異が引き起こす罠は現場のデバッグ工数を奪う大きな要因です。本稿では、C言語が大文字・小文字を区別する決定的な理由をはじめ、実務で頻出するコンパイルエラーの背景、さらには大文字小文字を無視して安全に比較・変換するための標準関数テクニックまで、現場目線で解説します。
【結論】C言語は大文字・小文字を厳格に区別する|基本原則とエラーの真相
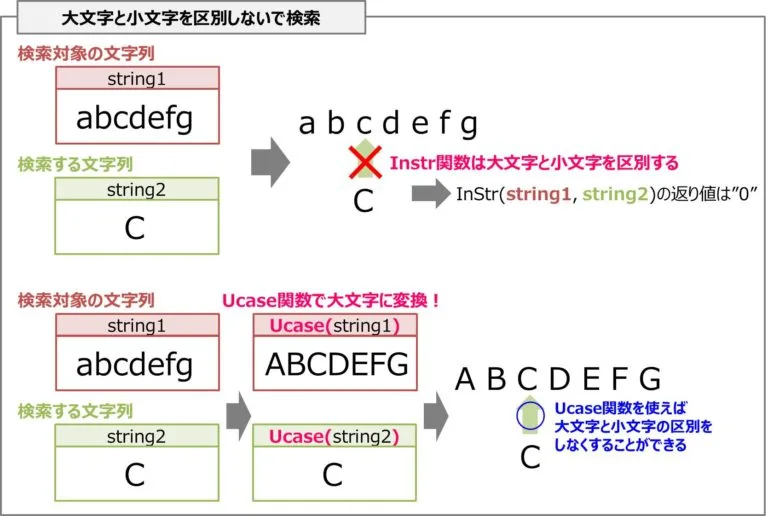
結論から明記すると、C言語は大文字・小文字を厳格に区別(ケース・センシティブ)します。言語仕様(ANSI C、ISO/IEC 9899規格)において、プログラム内でプログラマーが定義する「識別子(Identifier)」——すなわち変数名、関数名、構造体タグ名、typedef名、マクロ名などは、1文字でも大文字・小文字が異なれば完全に別の要素としてコンパイラに解釈されます。
例えば、次の3つの変数宣言はC言語においてすべて完全に別のメモリ領域を指す独立した変数として扱われます。
int count = 10;
int Count = 20;
int COUNT = 30;
開発現場で「なぜか値が更新されない」「変数が初期化されていないという警告が出る」という事象を調査した結果、宣言時と参照時で先頭文字の大文字小文字が単にズレていただけだった、という事例は開発現場の初歩的ミスの上位に常にランクインします。
また、C言語の関数名も大文字・小文字が区別されます。初心者が陥りやすい典型例が、エントリポイントであるmain関数をMainと記述してしまうミスです。この場合、コンパイラやリンカは「エントリポイントとなるmainが見つからない」と判定し、undefined reference to main'というリンカーエラーを返します。大文字小文字の違いは、文法エラーだけでなくビルドプロセスの根本を停止させる決定的な要因となるのです。
変数名や関数名でエラーが出る決定的な理由と識別子の命名規則
なぜC言語はこれほど厳格に大文字小文字を分けるのでしょうか。その理由は、内部処理におけるASCIIコード(文字コード)の直接的なマッピングにあります。コンピュータにとって文字とは単なる数値の並びであり、ASCIIコード表において大文字の'A'は65(0x41)、小文字の'a'は97(0x61)という全く異なる値が割り当てられています。コンパイラの字句解析フェーズにおいて、文字列トークンの一致をハッシュ値や数値比較で超高速に処理する設計思想が、C言語誕生期(1970年代初頭のUNIX開発)から受け継がれているためです。
実務における保守性を担保し、不要なコンパイルエラーを避けるためには、業界標準の識別子の命名規則を徹底することが防波堤となります。一般的に採用されているルールは以下の通りです。
- 通常変数・関数名:すべて小文字のスネークケース(例:
user_id,get_sensor_data)またはローワーキャメルケース(例:userId,getSensorData)。 - 定数・マクロ(#define):可読性と即時識別のためにすべて大文字(例:
MAX_BUFFER_SIZE,TIMEOUT_MS)。 - 型定義(typedef・構造体名):頭文字を大文字にするパスカルケース(例:
DeviceInfo)や、末尾に_tを付与する形式(例:device_info_t)。
大文字と小文字が持つ視覚的な意味合いをチーム内で統一しない開発環境では、typo(打ち間違い)によるバグの混入確率が跳ね上がります。
C言語における文字列比較・変換処理の徹底比較
ユーザー入力の検証やコマンド解析では、「大文字小文字を区別せずに一致判定を行いたい」という要件が日常的に発生します。しかし、標準のstrcmp関数をそのまま用いると、期待通りの結果は得られません。
大文字小文字の扱いに関する主要な関数とテクニックを、以下の比較表にまとめました。
| 関数 / 手法 | 詳細・挙動データ | 標準規格 / 移植性 | 編集部の見解・実務評価 |
|---|---|---|---|
| strcmp | ASCIIコード順で完全一致を評価("Apple" ≠ "apple") | ANSI C / ISO C標準(最高) | 厳格な照合に必須。非区別判定にはそのまま使えないため注意。 |
| strcasecmp | 大文字小文字を無視して比較("Apple" == "apple") | POSIX.1標準(Linux / macOS) | UNIX系ではデファクトだが、Windowsネイティブ環境では非対応。 |
| stricmp / _stricmp | 大文字小文字を無視して比較(動作はstrcasecmpと同等) | MSVC独自仕様(Windows環境) | クロスプラットフォーム開発ではプリプロセッサでのラッパー必須。 |
| toupper / tolower | 1文字ずつ大文字または小文字へ変換する関数 | ANSI C / ISO C標準(最高) | 自前で正規化ループを組むことで、最も移植性の高い比較が可能。 |
大文字小文字を無視して文字列比較を行う実践テクニック
「大文字小文字を無視して一致を判定したい」場合、エンジニアが選択できるアプローチは大きく分けて2通りあります。
1. プラットフォーム依存関数(strcasecmp / _stricmp)の使い分け
Linux環境(gccやclang)では<strings.h>ヘッダーに含まれるstrcasecmpを使用し、Windows環境(Visual Studio / MSVC)では<string.h>の_stricmp(またはstricmp)を使用します。
マルチプラットフォームに対応させる場合、現場では以下のようなマクロ定義をヘッダーに配置するのが定石です。
#include <string.h>
#define strcasecmp _stricmp
#else
#include <strings.h>
#endif

// 使用例
if (strcasecmp(input, "quit") == 0) {
 // "QUIT", "Quit", "quit" いずれも一致
}
2. tolower / toupper を用いたポータブルな標準関数アプローチ
外部環境に依存しない最も確実な方法は、<ctype.h>に定義されているtolower(小文字変換)またはtoupper(大文字変換)を用いて、自前で1文字ずつ正規化しながら比較を行うアルゴリズムです。
#include <stdio.h>
#include <ctype.h>

int safe_case_insensitive_compare(const char s1, const char *s2) {
 while (s1 && s2) {
 int c1 = tolower((unsigned char)s1);
 int c2 = tolower((unsigned char)s2);
 if (c1 != c2) {
 return c1 - c2;
 }
 s1++;
 s2++;
 }
 return tolower((unsigned char)s1) - tolower((unsigned char)*s2);
}
ここで重要な技術的注意点として、tolowerやtoupperに渡す引数は(unsigned char)にキャストする必要があります。負の値を持つchar型が暗黙の型変換でintに拡張されると未定義動作を引き起こすリスクがあるためです。
一般に知られていない盲点とネットの誤解
ネット上のQ&Aサイト等で頻繁に見受けられる誤解として、「ファイルインクルードは大文字小文字を適当に書いても通る」という言説があります。
例えば、#include "myHeader.h"と書くべきところを#include "myheader.h"と記述した場合、Windows(NTFS)の開発環境ではファイルシステムが大文字小文字を区別しない(Case-preserving but insensitive)ため、何のエラーも出ずにビルドが成功してしまいます。しかし、そのソースコードをLinux(ext4など)ベースのCI/CD環境や本番サーバーにプッシュした瞬間、「No such file or directory」という致命的なコンパイルエラーを吐き出してパイプラインを停止させます。
「Windows環境で動いたから問題ない」という思い込みは、クロスプラットフォーム開発における最大の落とし穴の一つです。
【プロの結論】開発チームが導入すべき命名と運用の判断基準
組織における開発品質の劣化を防ぐため、以下の判断基準をプロジェクト規約に設けることを推奨します。
- 導入すべきルール:CIパイプラインにおいて静的解析ツール(Clang-TidyやCppcheck)を常時稼働させ、命名規則違反および大文字小文字のtypoを自動検知する環境を構築する。
- 避けるべき設計:
dataとDataのように、大文字小文字の違いだけでスコープ内に別々の変数を共存させるコードは可読性を破壊するため、コーディング規約で一律禁止とする。
【c 大文字 小文字 区別】に関するよくある質問(FAQ)
Q1:C言語で大文字と小文字を変換するにはどの関数を使うのがベストですか?
A1:1文字単位の変換には<ctype.h>のtoupper(大文字化)またはtolower(小文字化)を用います。文字列全体を一括変換する標準関数は存在しないため、ポインタや配列のループを用いて1文字ずつ変換処理を適用します。
Q2:strcmp関数は大文字小文字を区別しない比較ができますか?
A2:できません。標準のstrcmp関数は文字コード(ASCII値)の大小を直接比較するため、大文字小文字を厳格に区別します。大文字小文字を区別しない比較を行いたい場合は、Linux環境ならstrcasecmp、Windows環境なら_stricmpを使うか、tolower等を用いた自作の比較ロジックを実装します。
Q3:マクロ名(#define)をすべて大文字にするのはなぜですか?
A3:C言語のプリプロセッサマクロは単純なテキスト置換を行うため、通常の変数や関数と混同すると意図しない副作用(二重評価など)を生み出す危険があります。「大文字のみで記述された識別子は定数またはマクロである」という暗黙の了解を視覚的に明示し、保守時のバグを防ぐためです。
まとめ:今後の動向と失敗しないための判断基準
C言語における「大文字・小文字の区別」は、言語仕様の根幹をなす不変のルールです。変数名や関数名でのビルドエラーを防ぐためには、厳格な命名規則を策定し、開発者一人ひとりがASCIIコードに基づいた内部動作を正しく把握しておく必要があります。
加えて、文字列比較においては動作環境(WindowsとLinux)のAPIの差異を考慮し、移植性を重視するなら標準関数tolower/toupperによる正規化を、速度を最優先するならOSごとの比較関数を適切にラッピングして運用することが、堅牢なソフトウェア開発を実現するための確固たる判断基準となります。